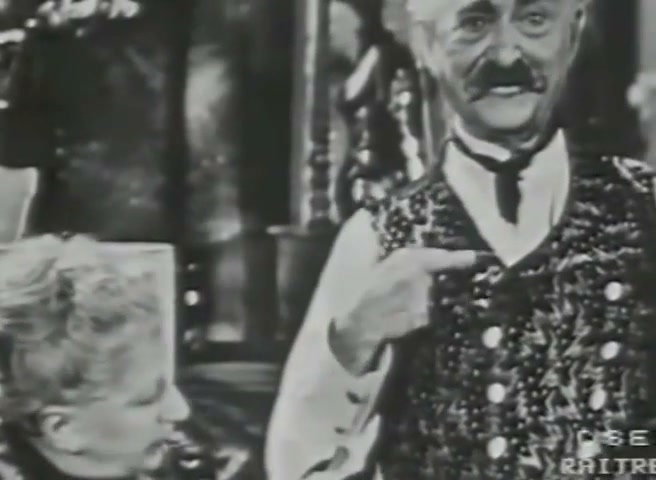Prevedere: un LLM (Large Language Model, grande modello linguistico) sceglie il token successivo
Verosimile: probabile non vuol dire vero
Frastagliata: bravissimo in un compito, pessimo in quello accanto
Pesi, token, contesto e finestra di contesto
Ricompense: RLHF (Reinforcement Learning from Human Feedback, apprendimento per rinforzo da valutazioni umane)
Oggi: laboratorio
Scrivere istruzioni efficaci: il prompt come brief
Produrre testi con un chatbot gratuito
Guardare i risultati con occhio critico, insieme
Regola del giorno: condividiamo istruzioni e risultati
Ogni risultato si mostra con il prompt che l'ha prodotto
Gli errori valgono quanto i successi: sono materiale di studio
Si dichiara sempre lo strumento usato e il livello d'uso (Gradiente IA)
01
Anatomia di un prompt
Schema tradotto e ridisegnato da Grant, R. M. (2010). Contemporary Strategy Analysis, 7th ed. Chichester: Wiley Ed. it.: Grant, R. M. (2020). L'analisi strategica per le decisioni aziendali, 6ª ed. Bologna: il Mulino
Un prompt è un brief
MAPS: le quattro parti del brief
Mission: obiettivo e ruolo
Audience: pubblico e tono di voce
Place: il contesto
Safeguard: vincoli e barriere
Mission: obiettivo e ruolo
Che cosa deve esistere alla fine, e come capisco che è riuscito
Chi sei, o quale ruolo deve prendere il modello
Senza obiettivo, il modello sceglie per te: la media
Mission: “Agisci come un esperto” è troppo generico
Un ruolo generico non migliora le risposte
Contano obiettivo, pubblico e criteri
Il ruolo serve se porta un punto di vista preciso
Zheng, M. et al. (2024). When “A Helpful Assistant” Is Not Really Helpful. Findings of EMNLP 2024
Audience: pubblico e tono di voce
Chi leggerà il risultato, e che cosa sa già
A che cosa serve: decidere, convincere, informare
Tono di voce: formale, colloquiale, tecnico, ironico
Place: il contesto
La situazione: dove, quando, dentro quale progetto
Quello che il modello non può sapere: storia, decisioni già prese, abitudini della casa
Materiale allegato ed esempi del risultato voluto
Place: esempi dal contesto
Apprendimento dal contesto(in-context learning)
Due o tre esempi del risultato voluto, dentro il prompt
Il modello imita la forma: anche i difetti degli esempi
Brown, T. B. et al. (2020). Language Models are Few-Shot Learners. NeurIPS
Place: file e allegati di contesto invece di lunghe spiegazioni
Allega il materiale vero: brief, linee guida, esempi riusciti
Il modello lavora meglio sull'originale che sul tuo riassunto
Attenzione ai dati riservati: ne parliamo giovedì
Safeguard: vincoli e barriere
Lunghezza, lingua, formato del risultato
Che cosa evitare: termini, promesse, dati non verificati
Meglio dire che cosa fare che che cosa non fare
In senso lato sono i guardrail del brief (quelli tecnici stanno fuori dal prompt: li mette chi fornisce il servizio)
Safeguard: formato del risultato
Elenco, tabella, email, testo pronto da incollare
Struttura: titoli, sezioni, numero di punti
Uno schema da riempire vale più di una descrizione
Quanto e come: “Sii conciso”, “Dammi una spiegazione completa”, “Ragioniamo passo per passo”, “Alla fine fammi un report del tuo processo e delle tue scelte”
Esportazione: alcuni agenti lavorano per fasi, come NotebookLM (fonti, dialogo, esportazione in diversi formati)
Safeguard: concedi domande prima di iniziare il “pensiero profondo”
“Prima di rispondere, fammi le domande che ti servono”
Emergono le lacune del brief?
Rispondi alle sue domande, poi lascialo scrivere
Prompt debole
“Scrivi un post su LinkedIn per il nostro corso serale di fotografia.”
Chi scrive? Per chi, con che tono? In che situazione? Con quali limiti?
Il modello riempie i vuoti con la media
Prompt forte
Mission: scrivi come responsabile dei social di una scuola di fotografia, per ottenere iscrizioni al corso serale (ottobre, 8 incontri)
Audience: principianti tra 30 e 45 anni, a Milano, tono caldo e concreto
Place: allego il programma del corso e due post che hanno funzionato
Safeguard: massimo 120 parole, niente superlativi, tre proposte diverse con un titolo
Esercitazione
10′
Il tuo prompt a colori: Mission, Audience, Place, Safeguard
Scegli un compito vero del tuo lavoro o del tuo studio;
scrivi il prompt a mano, su carta;
evidenzia con quattro colori le parti MAPS: obiettivo e ruolo, pubblico e tono, contesto, vincoli;
se manca un colore, aggiungi la parte che manca: tutto deve stare in un colpo d'occhio.
Gradiente 1Autonomia
Esercitazione
10′
Dal testo al grafico: trasformalo in un'infografica con un agente IA
Fotografa o trascrivi il tuo prompt a colori;
chiedi a un chatbot di trasformarlo in un'infografica: uno schema a colori con le parti del prompt;
confronta con il tuo foglio: che cosa ha capito, che cosa ha perso?
correggi con una sola istruzione in più.
Gradiente 4Regia
02
Far ragionare, non far indovinare
Catena di ragionamento (CoT, Chain of Thought)
Chiedere i passaggi intermedi prima della risposta
Se diamo esempi di ragionamento, i modelli risolvono più problemi di aritmetica e di logica
Basta anche una frase: “Ragioniamo passo per passo”
Wei, J. et al. (2022). NeurIPS Kojima, T. et al. (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS
Tracce di ragionamento: il taccuino del modello
Tracce di ragionamento(reasoning traces): prima un testo di lavoro, poi la risposta
Ogni token scritto diventa contesto per il successivo: il taccuino aiuta
Ma la traccia non sempre racconta come il modello è arrivato alla risposta
Turpin, M. et al. (2023). Language Models Don't Always Say What They Think. NeurIPS
Modelli che “pensano”: livelli di sforzo
Da settembre 2024 (OpenAI o1) i modelli di ragionamento scrivono una traccia prima di rispondere
Nelle app si sceglie la modalità (rapida o “pensa”), in alcune e nelle API anche lo sforzo: basso, medio, alto
Più sforzo: più tempo e più costo, non sempre risposte migliori
La finestra di contesto si riempie
Istruzioni, allegati, tutta la conversazione: tutto impegna una disponibilità limitata di token
A ogni risposta il modello rilegge tutto da capo
Il prompt è solo una parte della finestra di contesto
Degrado del contesto (context rot)
Più testo in ingresso, risposte meno affidabili, anche lontano dal limite
2025: 18 modelli messi alla prova, tutti peggiorano con gli input lunghi
Ciò che sta in mezzo si perde più di ciò che sta all'inizio e alla fine
Hong, K., Troynikov, A., Huber, J. (2025). Context Rot. Chroma Liu, N. F. et al. (2024). Lost in the Middle. TACL, 12
Compattazione: il riassunto che dimentica
Compattazione(compaction): a finestra piena, il sistema riassume la conversazione
Il riassunto conserva il senso generale, perde i dettagli, a volte importanti
A perdersi possono essere proprio le istruzioni iniziali
Riscrivere: registro o tono di voce, lunghezza, pubblico
Strutturare: scalette, tabelle, elenchi
Estrarre dati
Proporre varianti e prime bozze
Esercitazione
10′
Sintetizzare un documento lungo
Scegli un documento pubblico di almeno dieci pagine nel tuo settore di lavoro: un bando, un rapporto, un regolamento;
chiedi una sintesi in cinque punti per un pubblico preciso;
cerca ogni punto nel documento: c'è davvero?
[Facoltativo] leggi il documento con attenzione. Che cosa manca: la sintesi ha tolto qualcosa di importante?
Gradiente 3Co-creazione
La storia, con parole nostre
Mezzogiorno, un autobus pieno. Un giovane dal collo lungo, con un cordoncino al posto del nastro sul cappello
Se la prende con un vicino che secondo lui lo spinge apposta; poi vede un posto libero e corre a sedersi
Due ore dopo, davanti a una stazione, un amico gli dice di spostare più in alto un bottone del soprabito
Da Queneau, R. (1947). Exercices de style. Paris: Gallimard; trad. it. U. Eco, Esercizi di stile, Einaudi, 1983
Esercitazione
13′
Esercizi di stile: una storia, tanti modi (Queneau, 1947)
Pesca uno stilehttps://www.random.org/lists/: telegramma, verbale dei carabinieri, reclamo all'azienda dei trasporti, recensione, oroscopo, ricetta, solo domande, al contrario, sonetto, eccetera;
riscrivi la storia a mano, senza IA (5′); Gradiente 1Autonomia
chiedi lo stesso stile a un chatbot; Gradiente 3Co-creazione
poi chiedigli dieci stili in un colpo solo. Gradiente 3Co-creazione
Gassetta e pomello, asola e bottone: la stessa battuta di Gilberto Govi, detta e ridetta in modi diversi, fa ridere ogni volta. I manezzi pe majâ na figgia, ripresa televisiva RAI di Vittorio Brignole, 1959, con Rina Gaioni. Fotogramma da YouTube.
Esercitazione
8′
Dal testo alla tabella: estrarre dati
Prendi un testo con dati sparsi: un articolo, un verbale, un report autorevole;
chiedi una tabella con le colonne che decidi tu;
chiedi di scrivere «non indicato» quando il dato manca;
controlla tre righe a caso sul testo originale.
Gradiente 3Co-creazione
Esercitazione
10′
Un brief di comunicazione (per chi fa marketing)
Scegli un prodotto o un servizio reale;
chiedi al modello di farti le domande che servono per un brief;
rispondi, poi fatti scrivere il brief: obiettivo, pubblico, messaggio, canali, come misurare;
sottolinea ciò che è generico: varrebbe per qualunque prodotto?
Gradiente 3Co-creazione
Esercitazione
10′
Un concept di progetto (per chi fa design)
Descrivi un problema d'uso reale: un oggetto, un servizio, uno spazio;
chiedi tre concept diversi, ciascuno con un nome e tre righe;
scegline uno e chiedi i suoi punti deboli;
riscrivi il concept a parole tue: che cosa tieni, che cosa scarti?
Gradiente 3Co-creazione
Verificare: fatti, numeri, citazioni
Fatti: una fonte indipendente, non il chatbot stesso;
numeri: rifai il conto, risali al dato originale, su grandi quantità di dati vanno fatti controlli a campione;
citazioni: trova il testo, trova la frase nel testo, mai fidarsi. Una fonte citata dal modello può non dire ciò che il modello le attribuisce.
La responsabilità resta tua
Pausa 15′
Le parole della giornata
prompt — MAPS — apprendimento dal contesto — catena di ragionamento
tracce di ragionamento — livelli di sforzo — finestra di contesto
degrado del contesto — compattazione — esercizi di stile
Da provare
Invito al test: i più noti modelli con una versione gratuita
Lo sguardo come impronta: il modo in cui esploriamo una scena rivela priorità personali, al punto da riconoscerci. Haskins, Packard, Robertson (Dartmouth), PNAS, 2026
Brown, T. B. et al. (2020). Language Models are Few-Shot Learners. NeurIPS, 33.
Haskins, A. J., Packard, K. O., Robertson, C. E. (2026). Conceptual priorities shape individual gaze patterns during naturalistic visual attention. PNAS.
Hong, K., Troynikov, A., Huber, J. (2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma Technical Report.
Kojima, T. et al. (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS, 35.
Liu, N. F. et al. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the ACL, 12, 157–173.
Mistral AI (2026). Le Chat is now Vibe. Mistral Help Center.
Queneau, R. (1947). Exercices de style. Paris: Gallimard; trad. it. U. Eco, Esercizi di stile. Torino: Einaudi, 1983.
Turpin, M. et al. (2023). Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. NeurIPS, 36.
Wei, J. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS, 35.
Zheng, M., Pei, J., Logeswaran, L., Lee, M., Jurgens, D. (2024). When “A Helpful Assistant” Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of EMNLP 2024.