Un prompt a colori: Mission, Audience, Place, Safeguard
Far ragionare, non far indovinare: la finestra di contesto si riempie
Esercizi di stile: la forma cambia il senso, anche per un modello
Oggi: oltre il testo
Immagini, video, voce, musica: come nascono
Un'orchestra di modelli: il flusso multimodale
Laboratorio: un prompt per immagini, parte per parte
01
Oltre il testo
Multimodale: più modi di ingresso e di uscita
In ingresso: testo, immagini, voce, documenti, video
In uscita: testo, immagini, voce, musica, video
Molti chatbot vedono, ascoltano e parlano nella stessa conversazione
Immagini: dal rumore alla forma (modelli a diffusione)
Addestramento: si aggiunge rumore a milioni di immagini, un passo alla volta
Il modello impara a togliere il rumore
In uso: parte da rumore puro e lo “ripulisce” verso l'immagine descritta
Ho, J., Jain, A., Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. NeurIPS Rombach, R. et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. CVPR
Prima del modello a diffusione: due reti in gara (GAN, Generative Adversarial Network)
Una rete produce volti, l'altra cerca di smascherarli
A furia di sfidarsi, i falsi diventano indistinguibili
Febbraio 2019: un sito (segue link) mostra un volto nuovo a ogni ricarica. Nessuno di loro esiste
Goodfellow, I. et al. (2014). Generative Adversarial Nets. NeurIPS Karras, T., Laine, S., Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks. CVPR
Da provare — ricarica la pagina
Phillip Wang — This Person Does Not Exist (2019), volti generati con StyleGAN a partire da 70.000 foto prese da Flickr
Fei-Fei Li — Come stiamo insegnando ai computer a capire le immagini (TED, 2015, 18′): ImageNet, milioni di foto etichettate a mano per addestrare la visione artificiale
Immagini (modelli specializzati): Mokker (rimozione dello sfondo), Deevid.ai (tutto in uno: animazioni, inserimenti grafici, cambi di registro), Pebblely (still life di prodotto)
Video: Gemini e Flow (Google), Kling, Runway, Seedance
Voce: ElevenLabs, le modalità vocali di ChatGPT e Gemini, Piper (open source, in locale)
Senza IA: eSpeak NG, sintesi vocale open source che Claude può usare da riga di comando
Musica: Suno, Udio
Claude legge le immagini ma non le genera
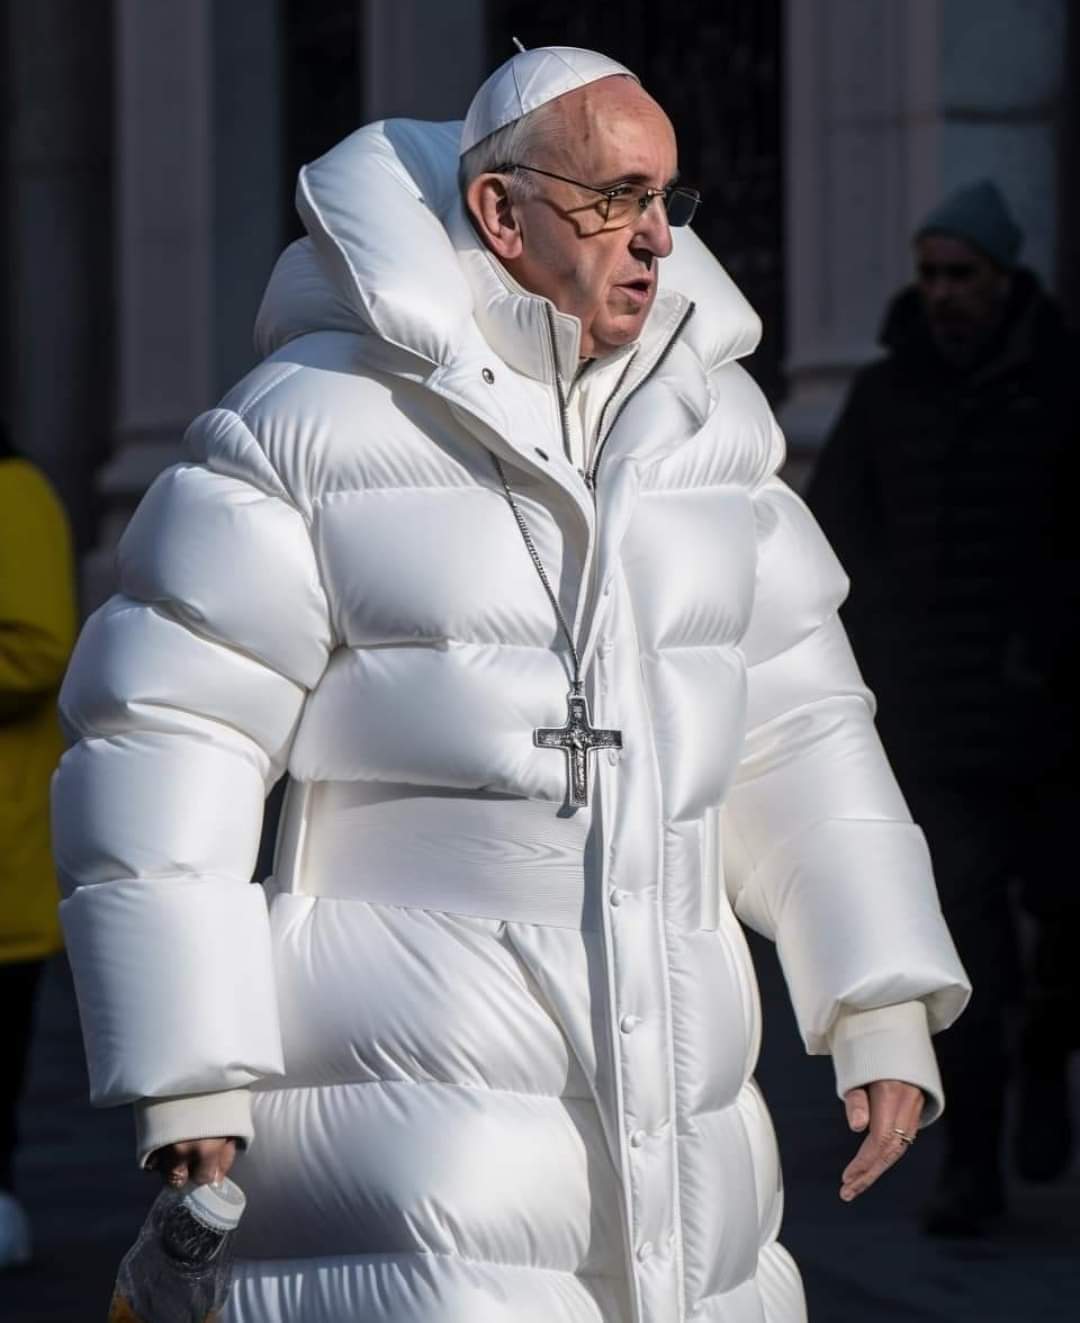
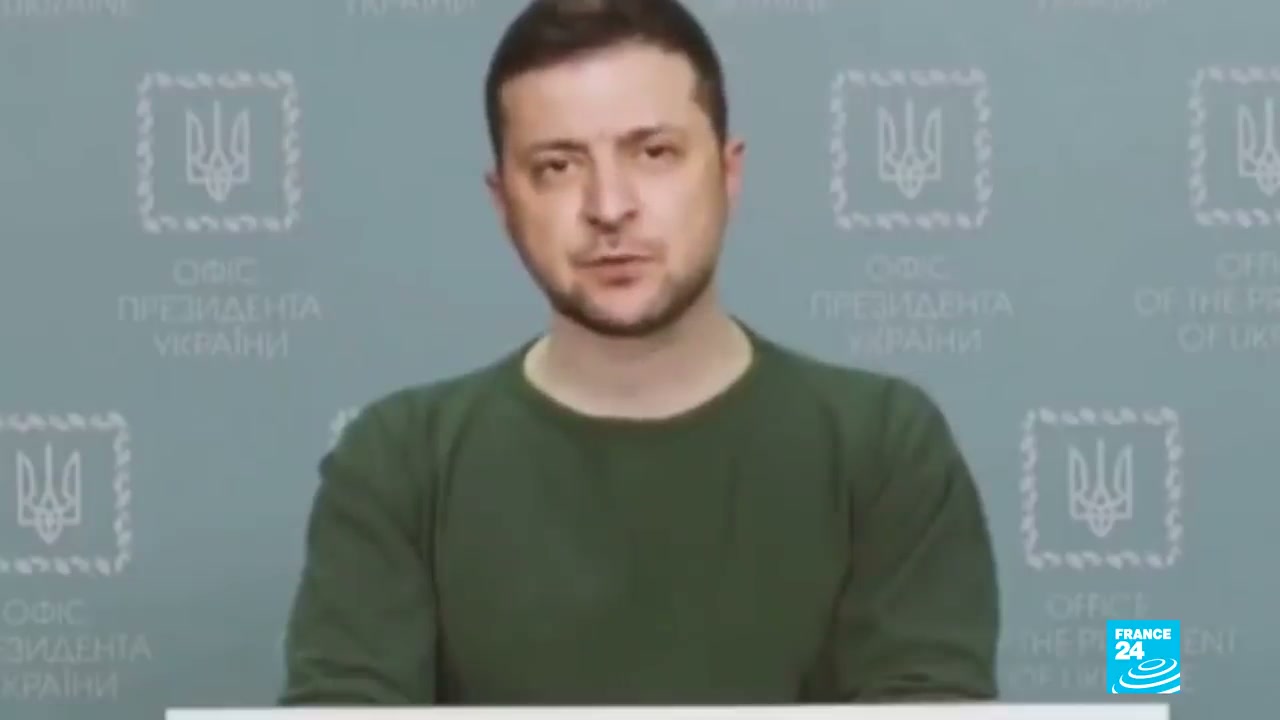
Il falso perfetto
Il Papa con il piumino bianco: immagine generata con Midjourney da Pablo Xavier (r/midjourney, 24 marzo 2023) — pubblico dominio, via Wikimedia Commons
1. Il modello linguistico sviluppa concept e testi
2. Scrive le istruzioni per le immagini
3. Il modello di immagini genera le proposte
4. Tu scegli, correggi, rimandi indietro
Il modello linguistico scrive le istruzioni per il modello di immagini
Descrizioni lunghe e precise: soggetto, luce, stile, formato
Spesso succede già da sé: il chatbot riscrive il tuo prompt prima di disegnare
Chiedi di vedere il prompt riscritto: capisci che cosa è cambiato
Betker, J. et al. (2023). Improving Image Generation with Better Captions. OpenAI
Dove si perde qualità a ogni passaggio
Ogni passaggio riassume e interpreta: come il telefono senza fili
I dettagli specifici diventano generici
L'errore del primo modello arriva ingrandito all'ultimo
Chi tiene la regia
Il flusso lo decidi tu: quali modelli, in che ordine, con quali istruzioni
Guardi ogni risultato prima di passarlo al modello successivo: un errore a monte si moltiplica a valle
Alla fine firmi tu: dichiari strumenti e livello d'uso (Gradiente IA, G1 p. 9)
Se affidi la regia a un modello, si discute solo della responsabilità soggettiva: quella oggettiva resta di chi attiva lo strumento, l'ultima persona che ha dato disposizioni, ruoli e vincoli (o non li ha dati)
Pausa 15′
03
Laboratorio: immagini
Anatomia di un prompt per immagini
Soggetto e azione
Sfondo e contesto
Stile
Fotografia: composizione, luce, inquadratura
Formato e proporzioni
Soggetto e azione
Chi o che cosa, mentre fa che cosa, dove
Dettagli concreti: materiali, età, abiti, oggetti
Una scena sola: troppe cose insieme si confondono
Sfondo e contesto
Dove e quando: luogo, epoca, stagione, ora del giorno
Lo sfondo racconta: lo stesso gesto in una cucina di casa o in un laboratorio cambia senso
Se non lo dici, il modello sceglie lo sfondo più probabile, cioè il più banale
Stile: descrittori e riferimenti
Tecnica: acquerello, incisione, fotografia su pellicola
Epoca e corrente: manifesto costruttivista, fumetto a linea chiara
Un'immagine di riferimento allegata vale più di dieci aggettivi
Fotografia: composizione, luce, inquadratura
Inquadratura: campo lungo, primo piano, dall'alto
Luce: controluce, luce radente, luce del tramonto
Il lessico della fotografia e del cinema funziona
Formato e proporzioni
16:9 per lo schermo, 1:1 e 4:5 per i social, 9:16 per le storie
Dichiara il formato subito, non dopo
Il testo nell'immagine: meglio aggiungerlo dopo, con un programma di grafica
Esercizi di stile per immagini: una scena, tre stili
La scena: davanti a una stazione, il giovane dal collo lungo e dal cappello con il cordoncino ascolta un amico che gli indica dove spostare un bottone del soprabito;
scegli tre stili. Esempi: incisione su legno secentesca, fotografia di cronaca in bianco e nero, fumetto a linea chiara, manifesto costruttivista, vetrata, pixel art, storyboard a matita, geroglifici antico egiziani, mosaici tardo romani, eccetera;
cambia solo lo stile: soggetto, azione e inquadratura restano identici;
il personaggio resta riconoscibile? Quale stile comunica meglio la scena?
Gradiente 3Co-creazione
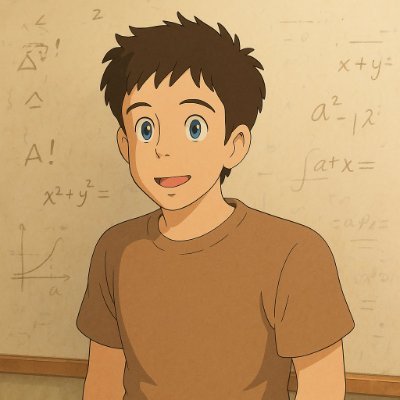
Marzo 2025: con GPT-4o, «in stile Ghibli» diventa una moda mondiale. Sam Altman, a capo di OpenAI, si rifà l'avatar; i server vanno in affanno. Il dissing: Jakob Nielsen pubblica il suo ritratto con la ricetta e nei commenti gli chiedono chi paghi Miyazaki. Intanto circola la frase del regista, «un insulto alla vita stessa», detta però nel 2016 davanti a un'animazione di tutt'altro tipo.
Chiedere uno stile d'artista: il nodo del diritto d'autore
Lo stile in sé non è protetto: lo sono le opere
Marzo 2025: OpenAI rifiuta lo stile di un artista vivente, ma accetta quello di uno studio
Un'immagine ottenuta solo con un prompt non è tutelata: serve il lavoro creativo di una persona
Resta la domanda: chi paga chi ha creato quello stile?
OpenAI (2025, 25 marzo). Addendum to GPT-4o System Card: Native image generation U.S. Copyright Office (2025). Copyright and Artificial Intelligence, Part 2: Copyrightability · L. 23 settembre 2025, n. 132, art. 25
Esercitazione
10′
Moodboard in due iterazioni
Scegli un progetto: un evento, un prodotto, un locale o uno spazio;
prima iterazione: sei immagini d'atmosfera con un solo prompt;
scegli le due più vicine all'idea e spiega perché;
seconda iterazione: riscrivi il prompt con ciò che hai imparato, poi confronta i due set di risultati.
Gradiente 3Co-creazione
Esercitazione
12′
Campagna visiva: tre immagini coerenti
Devi produrre tre immagini per la stessa campagna: stesso personaggio o prodotto, tre situazioni diverse, come in una pubblicità multi soggetto;
fissa gli elementi comuni: colori, luce, stile, formato;
usa la prima immagine come riferimento per creare le altre due;
c'è coerenza? Manca? Dove abbiamo dettagli incoerenti?
Gradiente 3Co-creazione
Gli artefatti: mani, testo, prospettiva
Mani: dita in più, in meno, fuse (oggi più rare)
Testo: lettere inventate, parole storpiate
Volti: labbra attaccate al naso, confuse con le ombre
Prospettiva, ombre e riflessi che non tornano
Attenzione al significato, solo parzialmente è un bisticcio: artefatto come sostantivo significa creato artificialmente mentre come aggettivo significa fatto con artificio ovvero inganno. Lo spostamento di significato è “artefatto” come se fosse verosimile e naturale quando non lo è (ricorda l'esempio dell'uccellino con testa di coccodrillo della conferenza TED di Fei-Fei Li)
Non solo errori: marchi e rappresentazione
Marchi e personaggi noti: spesso bloccati dalle barriere di sicurezza (guardrail)
Scelte di rappresentazione etnica: le correzioni per la diversità a volte allontanano la verosimiglianza
Febbraio 2024: Gemini disegna soldati tedeschi del 1943 di ogni etnia, Google sospende la generazione di persone
Raghavan, P. (2024, 23 febbraio). Gemini image generation got it wrong. We'll do better. Google
Com'è “una casa”?
Da leggere
Basu, A., Babu, R. V., Pruthi, D. (2023). Inspecting the Geographical Representativeness of Images from Text-to-Image Models. ICCV 2023